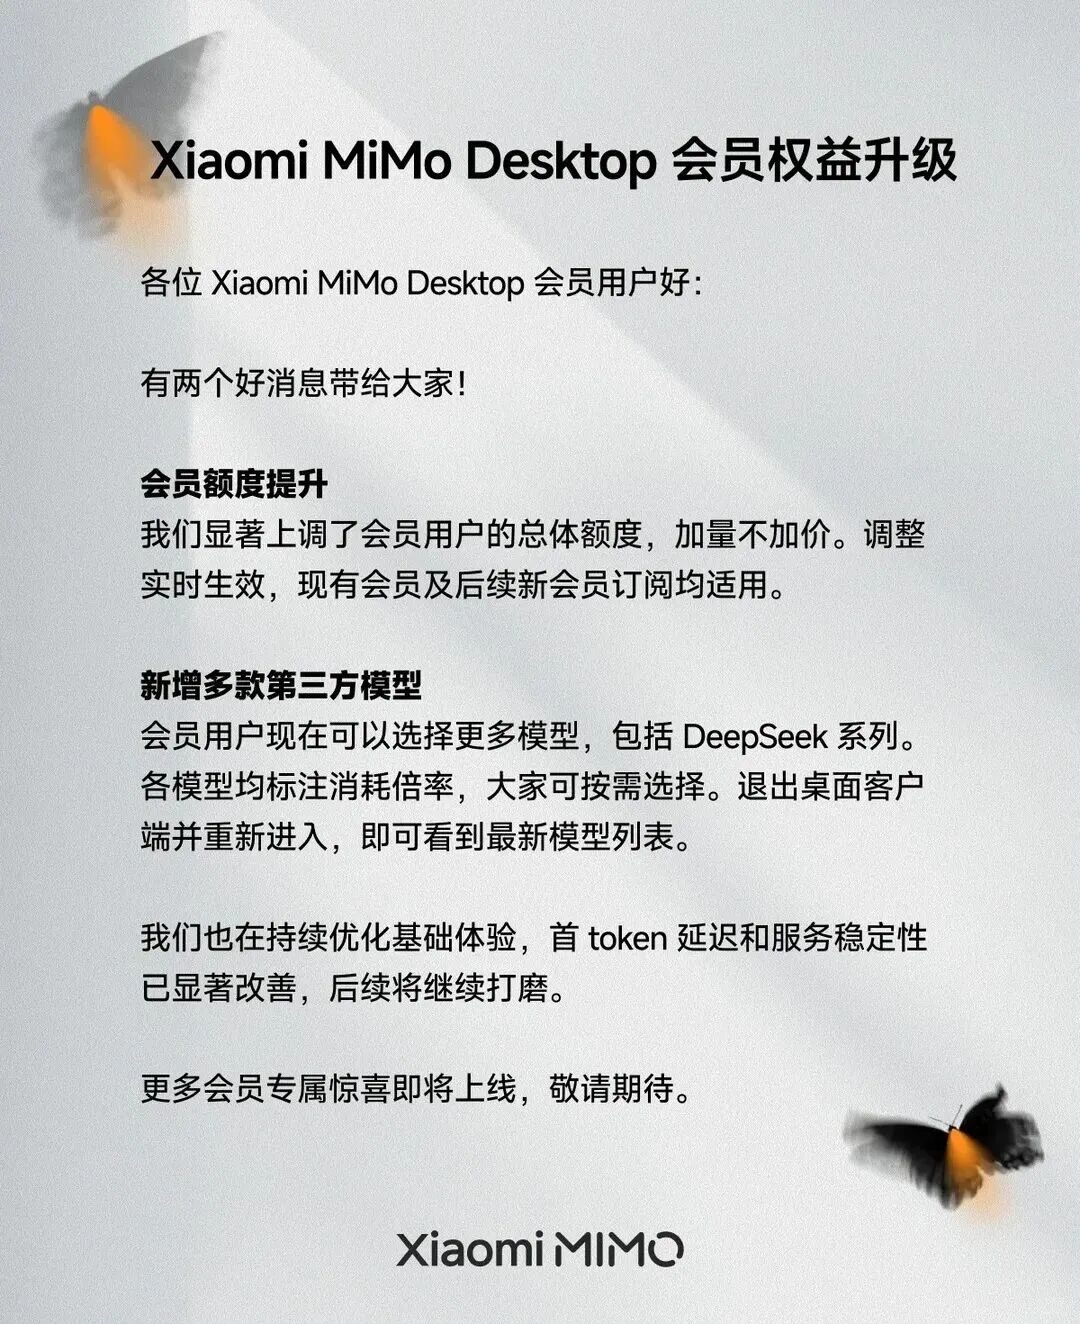
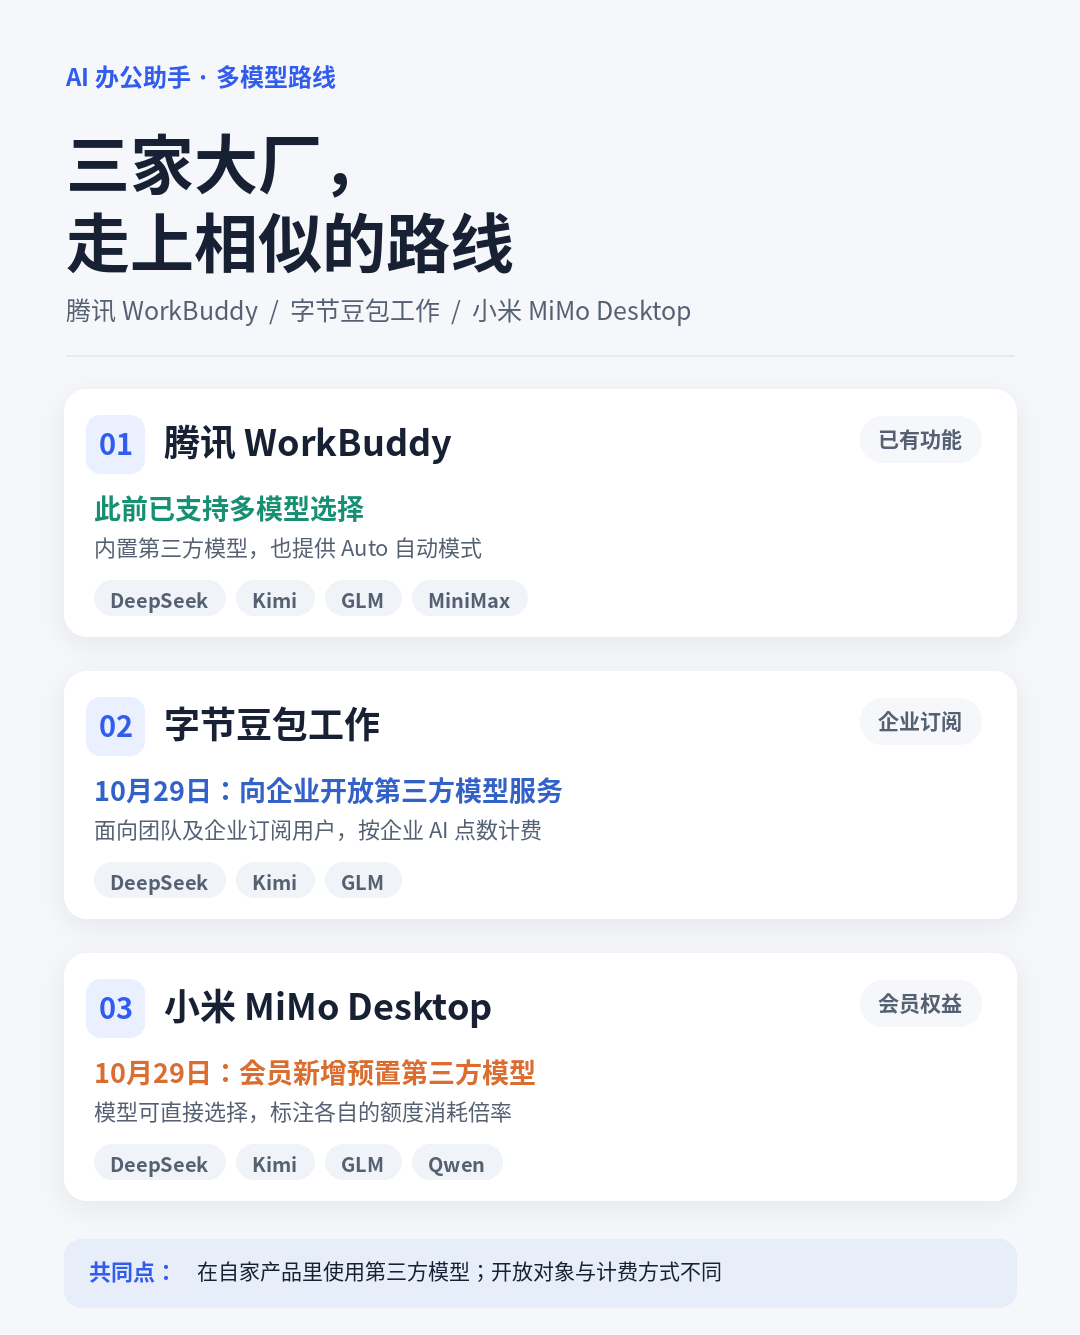
10月29日,小米 MiMo Desktop 更新了一版,把 DeepSeek、Kimi、GLM、Qwen 这些第三方模型,直接放进了会员可选列表。
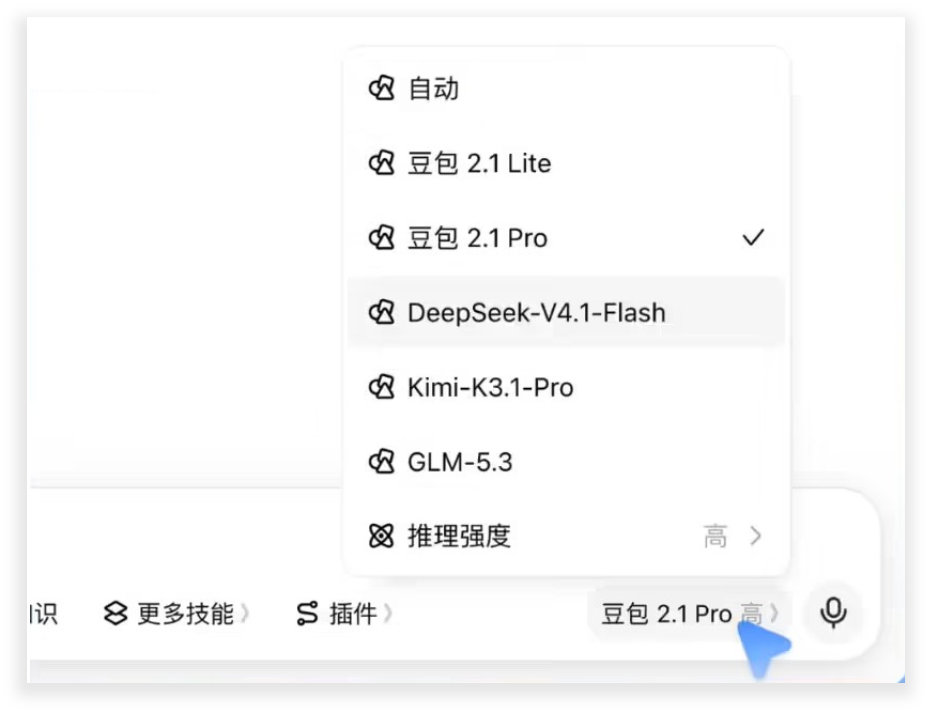
巧的是,同一天,字节的豆包工作也宣布,向企业客户开放第三方模型服务,首批接入 Kimi、GLM、DeepSeek。
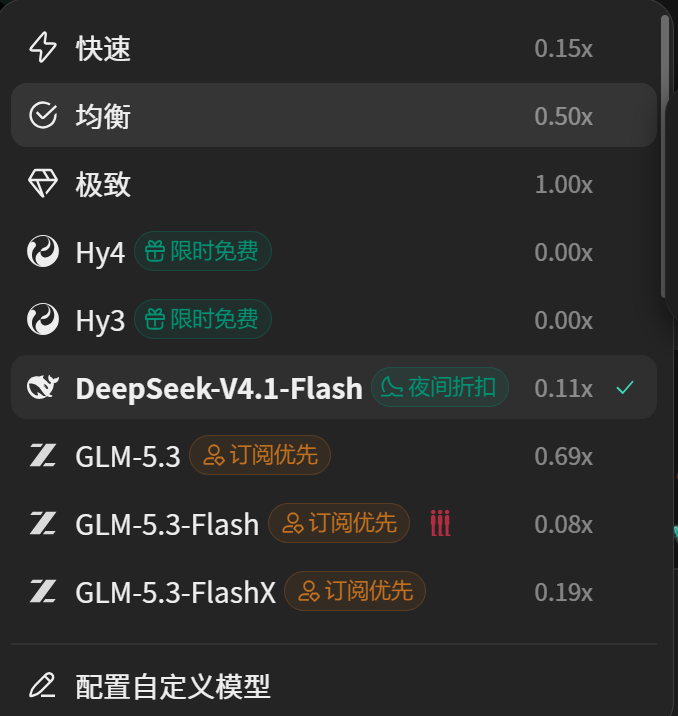
再往前翻,腾讯 WorkBuddy 早就这么干了,混元、DeepSeek、Kimi、GLM、MiniMax 都在里面,用户可以按任务切换。
三家大厂,同一天,同一个动作。
我看到这个消息的第一反应是:马化腾走过的路,张一鸣和雷军,还是跟着走了。
但更有意思的不是"谁跟谁",而是这件事背后透出来的东西。三家都在砸大钱自研大模型,现在却争着把对手的模型请进自家产品。这仗打到今天,逻辑已经变了。
一、先把事实摆清楚
小米这次的动作,有几个细节值得说。
第一,不只是加模型,还提了额度。会员总体额度上调,订阅价格不变。这个信号很明确,就是要拉人进来用。
第二,以前 MiMo Desktop 也能配第三方模型,但你得自己准备 API Key,自己折腾配置。这次是直接放进会员列表,点一下就能用,不同模型还标了额度消耗倍率。
从"你自己想办法"到"我给你配好",这一步跨得不小。说白了,小米是把门槛从技术门槛,降到了零。
字节那边也一样。豆包工作对企业客户开放第三方模型,免去单独采购,直接扣企业 AI 点数,还能统一管理权限。
你看,三家做的事几乎一模一样:把别人的模型,装进自己的壳里,用会员或者点数的方式卖出去。
二、为什么都往这条路上挤
我觉得核心就一句话:用户要的不是模型,是能干活的东西。
大部分人根本分不清 DeepSeek 和 GLM 有什么区别。他们只关心一件事,我让它写个方案、做个表、整理个会议记录,能不能干好、干得快、别出错。
不同的活,适合的模型不一样。写代码一个样,写文案一个样,处理长文档又一个样。用户没义务去研究这个,但产品得替他想好。
所以多模型选择这件事,本质上不是技术炫技,是把选择权收回来,替用户做掉。
腾讯 WorkBuddy 早看明白了这一点,所以它一开始就没打算只靠混元。Auto 模式一开,用户什么都不用管,系统自己挑。
现在字节和小米跟上了,说明这个判断被验证了。
还有个更现实的原因,我不说大家也懂。自研模型烧钱,烧得吓人。光靠自己的模型撑一个产品,成本压不住,体验也未必最好。把第三方的模型接进来,既补了短板,又摊了成本,还能对外说"我们选择多"。
一举三得。
三、这件事对老板们意味着什么
我做私域、做企业服务这么多年,看这种大厂动作,习惯性会想一个问题:这跟我读者的钱包有什么关系?
关系还真不小。
第一,AI 工具的采购逻辑变了。
以前企业买 AI,看的是"你用的什么模型",好像模型越大越牛逼。现在这个逻辑在失效。三家大厂都在混着用,你再去纠结底层是哪个模型,意义不大。
该看什么?看它能不能接进你现有的流程,看它能不能让你的员工少加两天班,看它的数据放不放心。
第二,别再自己造轮子了。
我见过太多老板,一听 AI 就想着搞个自己的平台、自己训个模型。这个念头,趁早打住。
大厂都在互相借模型,你一个中小企业,凭什么觉得自己能训出更好的?把钱花在"用起来"上,比花在"造出来"上,回报高得多。
第三,选工具要看它会不会被绑死。
多模型接入这件事,对用户其实是好事。你的活儿不会被一个模型卡住,这家不行换那家。所以你选工具的时候,也要看这一点:它是不是只认一家?只认一家的,将来涨价、降速、出故障,你只能干瞪眼。
四、我的一点判断
这波 AI 大战,打到现在,其实已经过了"比谁的模型强"的阶段。
模型会越来越像,差距会越来越小。真正拉开距离的,是谁能把模型变成普通人用得顺手的东西。
AI 这波是真机会,但机会不在"做AI",在"用AI"。
这句话我说过不止一次,今天再看这三家的动作,我更确信了。
腾讯先走了一步,字节和小米跟上来了。接下来会有更多家跟。等到大家都把第三方模型摆上货架的时候,多模型本身就不再是优势了,它变成标配。
到那时候,拼的是什么?
拼的是谁更懂用户的活,谁把流程做得更顺,谁能让一个完全不懂 AI 的老板,五分钟上手就能用出结果。
这才是真功夫。
对了,还有个事得提醒一句。大厂打架,对我们是好事,工具会越来越便宜、越来越好用。但也别被"免费""额度上调"这些词冲昏头,先想清楚自己要解决什么问题,再去选工具。